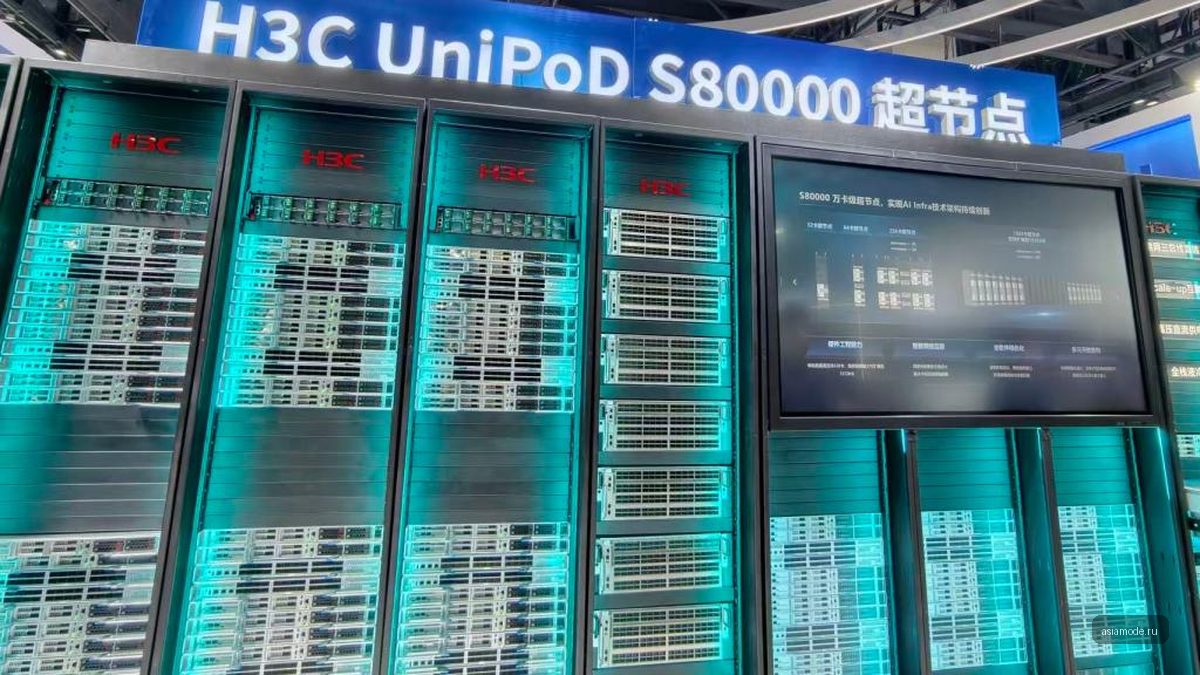
H3C переключает фокус с количества GPU на эффективность использования токенов
На прошедшей Apsara Conference 2026 компания H3C представила новый подход к развитию инфраструктуры искусственного интеллекта (ИИ). Если раньше ключевым словом в этой области было «больше вычислений», то сейчас акцент сместился на эффективность использования ресурсов. Вопрос, который задаёт отрасль: насколько эффективно можно использовать все эти вычислительные мощности?
От количества GPU к системной оптимизации
Как отметил Чжу Шиин, генеральный менеджер отдела передовых технологий H3C, современные кластеры ИИ — это высокоинтегрированные системы, требующие тесной координации между аппаратным и программным обеспечением. Простое добавление большего количества графических процессоров (GPU) не всегда приводит к пропорциональному увеличению производительности. Проблемы, такие как простаивающие мощности, перегрузка сети, нехватка данных и сложности управления крупными кластерами, могут снизить ценность дополнительных вычислений.
На конференции H3C представила свою линейку продуктов, включая UniPoD S80000 Series SuperPod, который поддерживает конфигурации от 32 до 1024 GPU и может масштабироваться до 16 384 GPU. Этот продукт поддерживает гетерогенные вычислительные ресурсы, включая CPU, GPU, NPU и DPU, а также популярные фреймворки. Вместо того чтобы просто добавлять больше чипов, компания фокусируется на координации вычислений, сети, хранения, облачных технологий, безопасности и операций, чтобы управлять различными типами ресурсов как единой системой.
Сети как потенциальное узкое место
Чжу Шиин также подчеркнул важность высокоскоростных соединений в инфраструктуре ИИ. По мере увеличения производительности GPU растёт и объём данных, передаваемых между ними. Если сеть не успевает за этим процессом, GPU вынуждены простаивать. H3C представила три сценария соединений: Scale-Up, Scale-Out и Scale-Across.
Внутри узла компания представила S9828-128EO, интеллектуальный коммутатор с кремниевой фотоникой, который снижает задержку на 15%. Между узлами используется коммутатор S9828-64FP, который сокращает энергопотребление на 20% в условиях высокой плотности. Для соединения между центрами обработки данных предназначен коммутатор S12500R-64EP, поддерживающий синхронизацию градиентов между центрами в пределах города.
Вызовы данных и хранения
Ещё одним важным аспектом является управление данными. GPU не могут работать без данных, а подготовка данных, обучение моделей и обмен параметрами требуют перемещения огромных объёмов информации. H3C представила серию UniStor X20000, которая обеспечивает пропускную способность до 200 ГБ/с и 3 миллиона операций ввода-вывода в секунду на узел. Это позволяет сократить время ожидания GPU на 30%, а задержку до первого токена — на 90%.
Инфраструктура ИИ превращается из центра вычислений в комплексную систему обработки данных. Каждая минута ожидания в процессе подготовки данных, обучения или генерации токенов оборачивается дополнительными затратами. Как отметил Чжу Шиин, после достижения определённого масштаба аппаратного обеспечения, оптимизация программного обеспечения становится всё более важной.
Источник: technode.com